COREMONIT · ENTERPRISE AI KNOWLEDGE SYSTEM
RAG WIKI LLM
Connecter toutes les connaissances de l’entreprise,
Trouver la réponse exacte au moment nécessaire.
Une solution RAG de connaissances d’entreprise qui relie les documents internes dispersés dans un système de connaissances IA unique pour fournir recherche, analyse, synthèse, comparaison, raisonnement et réponses standardisées. LOCAL LLMKNOWLEDGE HUBPDFWORDHWPREPORTDOC
Les données abondent, mais les connaissances exploitables manquent.
La compétitivité ne commence pas par le volume de documents, mais par la rapidité à trouver des preuves exactes au moment nécessaire.
Documents dispersés
Les documents sont dispersés entre PC personnels, NAS, dossiers partagés, outils collaboratifs et e-mails.
Limites de la recherche
Il faut connaître le nom exact du fichier ou les mots-clés pour trouver le contenu souhaité.
Rupture de transmission des connaissances
Lors des changements de responsables ou de l’arrivée de nouveaux collaborateurs, l’expérience et le savoir-faire ne sont pas transmis.
RAG : génération augmentée par la recherche
Avant de générer une réponse, l’IA recherche les documents internes de l’entreprise puis répond à partir des preuves vérifiées.
 QuestionSaisie en langage naturel02
 RechercheRecherche de documents pertinents03
 AnalyseCompréhension du contexte et de l’intention04
 RaisonnementComparaison et organisation des contenus05
 RéponseGénération fondée sur des preuves
- Centré sur les données d’entraînement
- Difficulté à vérifier les informations internes et récentes de l’entreprise
- Risque d’hallucination si les preuves sont insuffisantes
- L’utilisateur doit revérifier les sources
- Centré sur les documents approuvés en interne
- Prise en compte des derniers manuels, règlements et projets
- Répondre à partir des preuves trouvées
- Fournit les sources et l’emplacement du texte original
Fonctionnement de RAG WIKI LLM
Au-delà du stockage, nous transformons les documents en une structure de connaissances qui améliore à la fois la précision de recherche et la qualité de génération.
DATA SOURCE
PDF · Word · Excel · PPT · Wiki · Manual · Report
DOCUMENT
Parsing · Cleaning · Metadata · Classification
KNOWLEDGE
Chunking · Embedding · Indexing
STORAGE
Vector DB · Metadata DB · Document Storage
RAG ENGINE
Query · Hybrid Search · Re-ranking · Context
APPLICATION
AI Chat · Wiki · Report · Dashboard · API
Recherche RAG et CHATBOT dans un seul produit
CoreMonit RAG WIKI LLM associe une fonction de recherche RAG qui trouve des preuves dans les documents de l’entreprise et une fonction CHATBOT qui permet d’interroger les connaissances trouvées en langage naturel et d’obtenir des réponses.
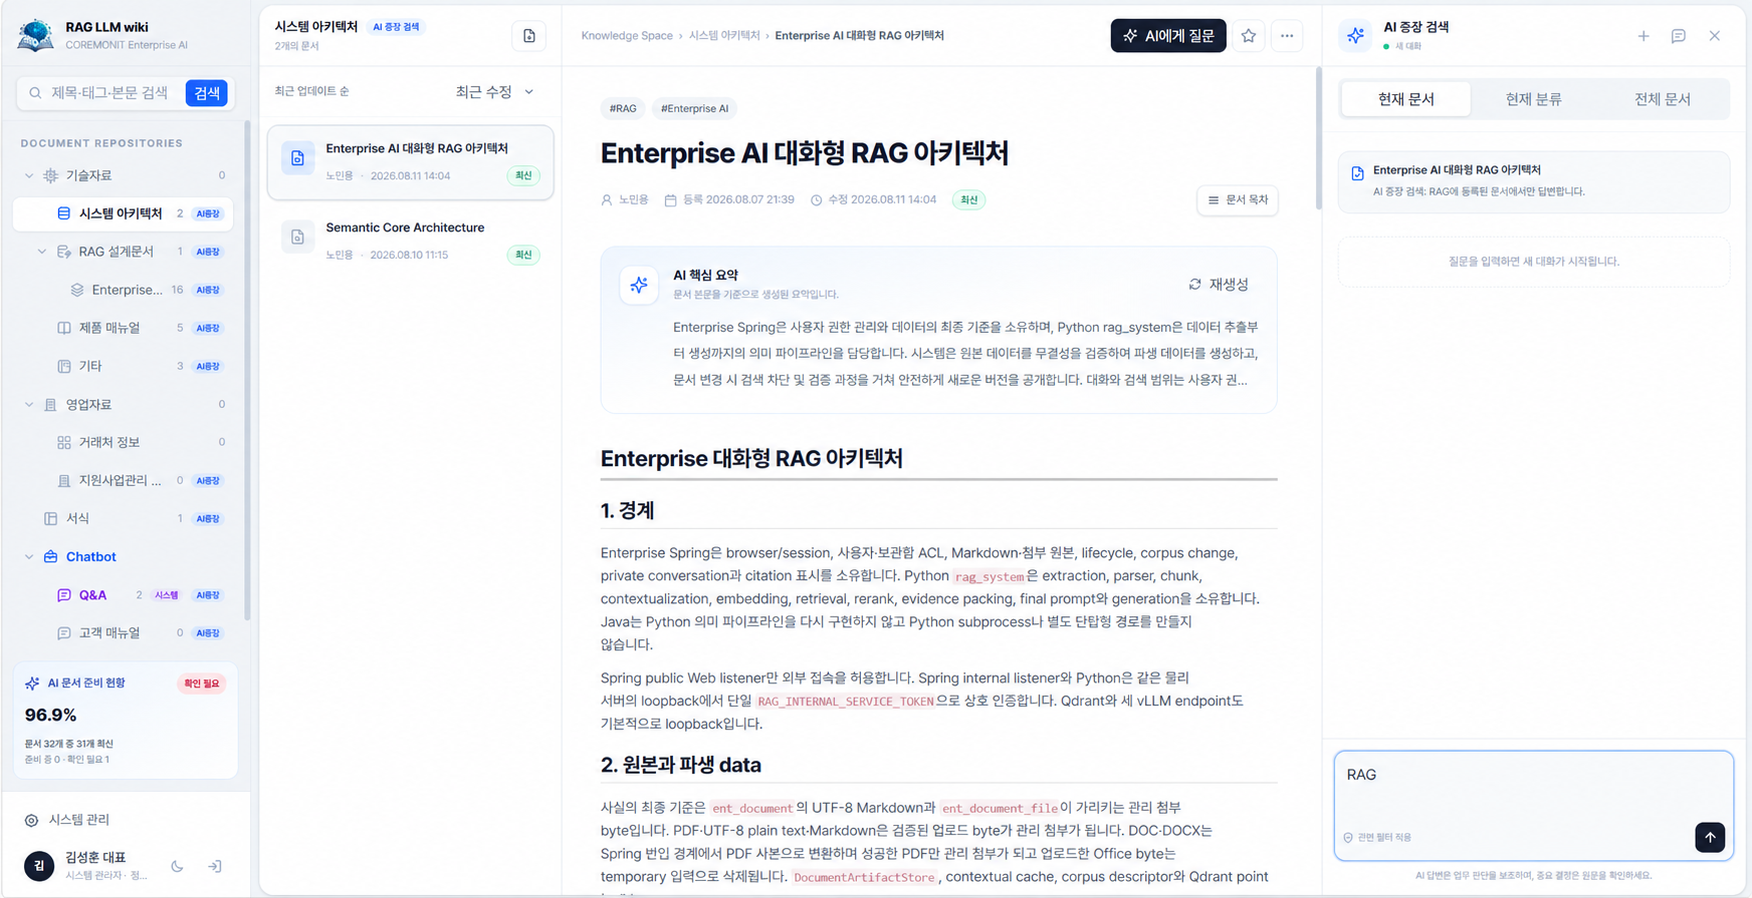
Explorez documents, classifications et emplacements des originaux sur un même écran et consultez rapidement les contenus approuvés liés à la question.
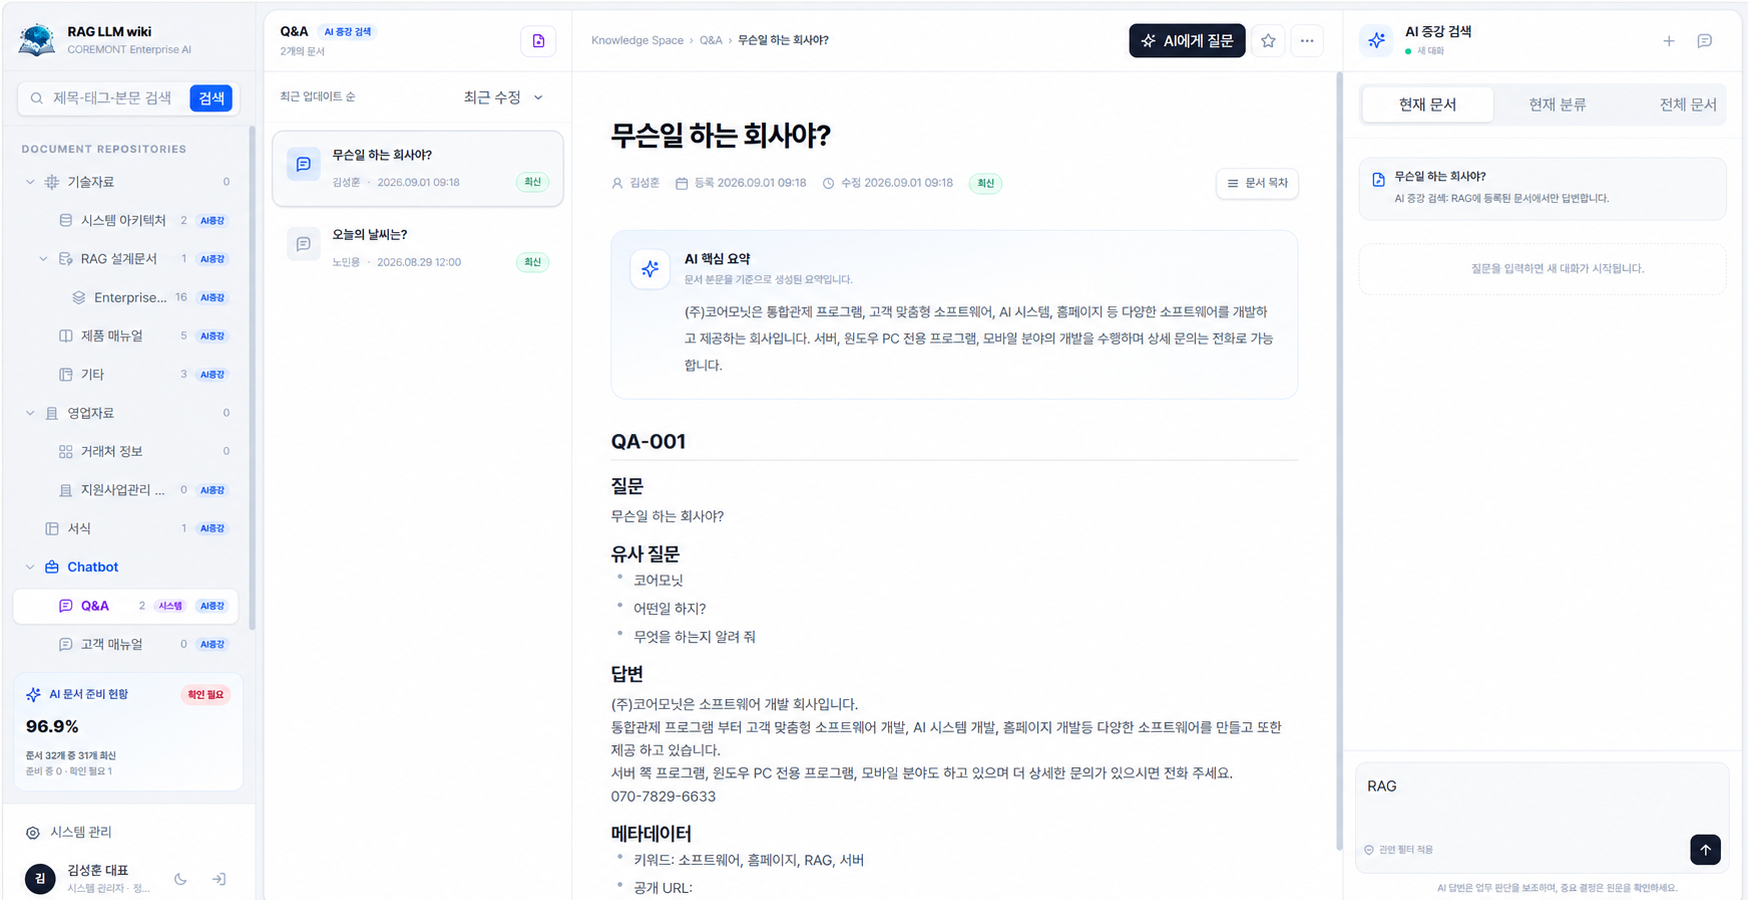
Répond aux questions à partir des connaissances internes trouvées et relie les questions similaires aux documents justificatifs.
Technologies clés de fonctionnement
Nous concevons la qualité globale du RAG, de l’identification précise des caractéristiques documentaires à la recherche sémantique, au reclassement et au raisonnement.
Importation de documents
Collecte de manière sécurisée les documents Word, PDF, wikis, manuels et données de qualité et de projet des services.
Parsing
Organise le texte, les titres, tableaux, auteurs, dates, numéros de document et métadonnées.
Chunking
Découpe les documents en unités sémantiques qui préservent le contexte environnant pour améliorer la précision de recherche.
Embedding
Transforme l’information en vecteurs pour trouver des documents de sens similaire malgré des formulations différentes.
Vector Search
Au-delà des mots-clés, recherche des documents probants sémantiquement proches de la question.
LLM de classe 30B
Compare et analyse plusieurs sources, puis synthétise, classe et raisonne selon l’intention de la question.
Re-ranking
Les résultats candidats sont reclassés selon leur pertinence pour la question afin de réduire les résultats inutiles.
Standard Parsing
Structure les réponses dans des formats métier : tableaux, listes de contrôle, synthèses et rapports.
Une chaîne RAG qui améliore la précision des recherches
Connecter une Vector DB ne suffit pas. Nous validons et optimisons de manière répétée l’ensemble du processus de recherche selon les données de l’entreprise.
Au-delà de la recherche, des résultats directement utilisables
Les résultats de recherche sont structurés en tableaux, synthèses, listes de contrôle et rapports pour une utilisation immédiate au travail.
Tableau
Compare les éléments, symptômes, niveaux d’urgence et services responsables.
Synthèse des points clés
Synthétise les enjeux clés et conclusions de plusieurs documents.
Liste de contrôle
Fournit les étapes de vérification et les actions à effectuer.
Rapport
Produit un rapport sur les symptômes, causes, mesures et prévention des récidives.
De la recherche documentaire à la recherche de connaissances
Posez une question au lieu de chercher un fichier pour obtenir les documents pertinents et l’emplacement des preuves.
Une IA privée pour exploiter les documents internes en toute sécurité
Nous minimisons l’exposition externe des données en tenant compte des politiques de sécurité et de l’environnement réseau de l’entreprise.
Règlements de l’entreprise et des RH / Contrats / Consignes d’exploitation
Documentation technique / Projets / Conception
Procédures de travail / Manuels des équipements et procédés
Critères d’inspection / Problèmes qualité / Manuels
Documentation produit / Propositions / Réponses clients
Voici des questions que vous pouvez poser au travail.
Une seule question en langage naturel permet de trouver documents pertinents, précédents et preuves nécessaires à la décision.
« Comment résoudre Error 105 ? »
« Quelle est la fréquence de remplacement de cette pièce ? »
« Quelles sont les différences fonctionnelles entre les produits A et B ? »
« Quels cas de dépannage figurent dans les précédents projets PLC ? »
« Retrouvez les historiques de pannes similaires récurrentes. »
« Présentez-moi l’organisation documentaire du projet. »
« Comment demander un déplacement professionnel ? »
« Quelles sont les règles relatives à la qualité ? »
Des bénéfices attendus qui transforment les méthodes de travail
Transformez les informations contenues dans les documents en patrimoine de connaissances et réduisez le temps consacré à la recherche et à la synthèse.
Chaque entreprise ayant ses propres données, son RAG doit aussi être différent.
Nous analysons les caractéristiques documentaires, les objectifs de recherche et les politiques de sécurité pour concevoir une architecture des connaissances et une chaîne de recherche personnalisées.
L’IA recherche et organise l’information.
La décision appartient à l’humain.